裏側のAI処理の費用が約1/23に。日本語の業務でLLM 4モデルを比べて分かった「1社だけに頼る」危うさ
「社内のAI活用はChatGPTのTeamプランで一本化している」
「企画や開発チームにはClaude Proを契約させている」
中小企業で生成AIの活用を進める際、このように特定のベンダーの月額プランを契約し、全社的な窓口に据えているケースは少なくありません。
総務省が公表した調査によれば、日本企業の生成AI利用率は徐々に拡大しているものの、中小企業における本格的な業務導入は道半ばであり、大企業との活用格差やコスト対効果の不透明さが指摘されています(出典:総務省「情報通信白書(令和6年版)」、2024年)。また、帝国データバンクの意識調査においても、生成AIを活用・検討する企業が増加する一方で、「コストに見合う効果が得られるか」「自社の特定業務に定着するか」といった費用対効果や運用の見極めが大きな課題として挙げられています(出典:帝国データバンク「生成AIの活用に関する企業の意識調査」、2024年)。
実際の業務に生成AIを組み込んでいくと、ひとつの大きな壁にぶつかります。「文章の要約は得意だが、スキャンした帳票の読み取りで誤読が起きる」「裏側で動かす小さな判定処理の回数が増え、想定以上にAPI費用が膨らんでいる」「頼りにしていた特定モデルの提供終了が発表された」といった問題です。
今回マーキュリーのグループで開発する業務支援システムにおいて、日本語の業務タスクを用い、主要なLLM(大規模言語モデル)4製品の実測比較検証を実施しました。
結論からお伝えすると、以下の3点が実証データとして明らかになりました。
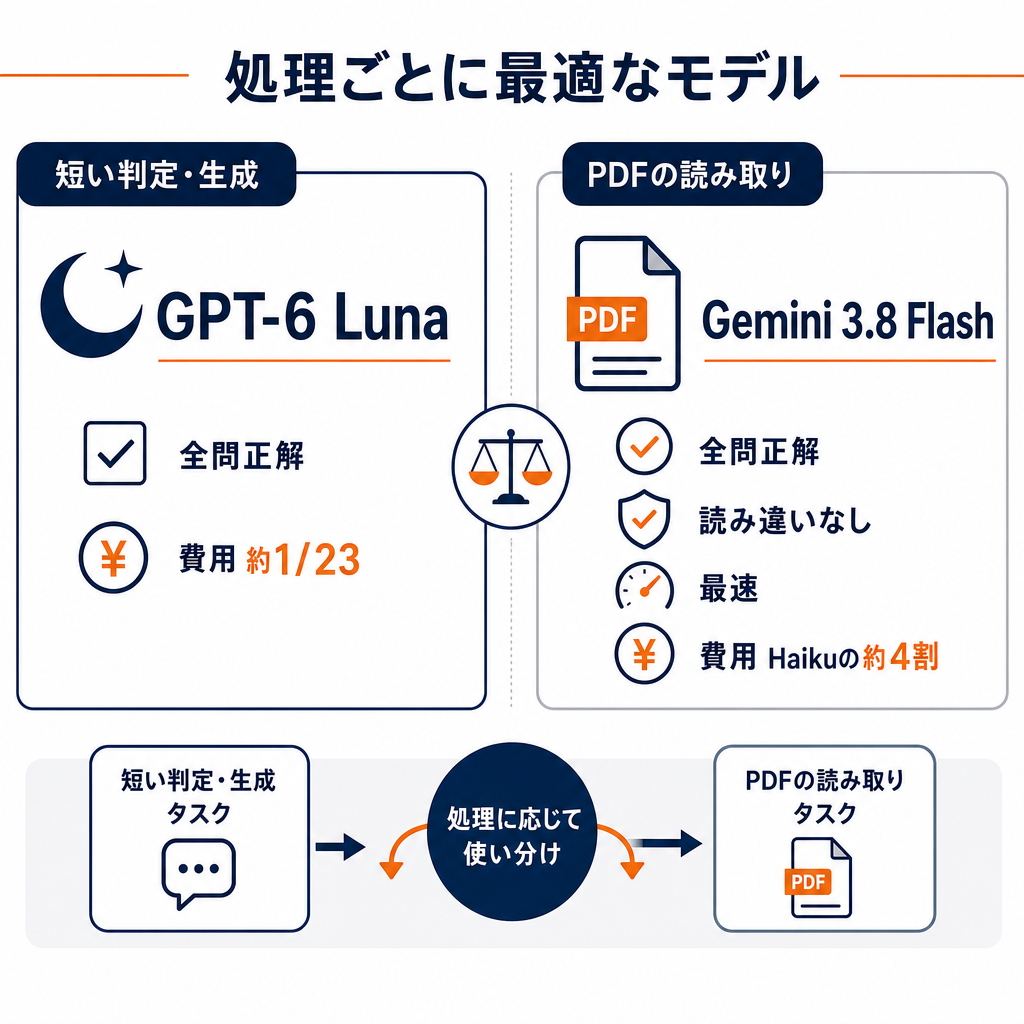
- 短い判定・生成タスク(4処理)において、GPT-6 Lunaが全問正解を記録し、正答1件あたりの実費はClaude Haiku 4.5の約1/23に削減された
- 添付PDFの読み取りにおいて、Gemini 3.8 Flashが全問正解・誤読ゼロ・最速を記録し、費用はClaude Haiku 4.5の約4割に収まった
- 「最適なモデル」はタスクごとに完全に分かれており、1社のAIモデルだけに固定していた場合、精度または費用のどちらかを大きく損なっていた
本記事では、この検証結果の詳細な内訳と、中小企業がAI基盤を選ぶ際に押さえるべき実践的な指針を解説します。
1. なぜ今、AIモデルを業務別に比較する必要があるのか
使っているAIモデルはある日突然提供終了になる
業務システムの裏側や日常業務のプロンプトで特定のモデルを指定している場合、避けて通れないのが「モデルの廃止・世代交代」です。
Anthropicの公式発表等によれば、軽量・高速モデルとして広く活用されてきた「Claude Haiku 4.5」は、2026年10月15日以降に提供が停止される可能性があるとされています。同社内で直接の後継となる同価格帯の小型モデルが直ちに用意されない場合、より上位で高単価なモデルへ迂回させるか、別ベンダーのモデルへ移行しなければなりません。
AIは「賢さのランキング」だけでは選べない
業務利用において重要なのは、ベンチマーク上の総合スコアだけではありません。「指示された出力形式を崩さないか(正確さ・形式)」「毎回同じ安定した結果を返すか(安定性)」「1回の呼び出しにかかる処理速度(速さ)」「1回あたりの実費(コスト)」の4軸で評価する必要があります。
とりわけ、画面裏で自動実行される「意図の判別」や「書類の要約」といった処理は、月間で数千・数万回呼び出されるため、単価のわずかな差が月々の運用コストに直結します。
※本検証は、マーキュリーのグループである信濃ロボティクスイノベーションズ合同会社が開発する業務支援システム「secondbrain.work」の検証環境にて、2026年9月26日に実施された実測データに基づいています。
2. 評価の設計:何を、どう比べたのか
比較対象とした4モデル
日頃の業務処理を担う軽量〜中位モデルを中心に、以下の4モデルを選定しました。
| モデル名 | 提供元 | 本検証における位置付け | 公称単価(100万トークンあたり・入力/出力) |
|---|---|---|---|
| Claude Haiku 4.5 | Anthropic | 従来標準として使用していたモデル(比較基準) | $1.00 / $5.00 |
| Claude Sonnet 5 | Anthropic | 同社の中位モデル(Haiku停止時の自動迂回先) | $2.00 / $10.00 |
| GPT-6 Luna | OpenAI | 最新の低価格・高効率モデル | $0.10 / $0.50 |
| Gemini 3.8 Flash | HaikuとLunaの中間に位置する高速モデル | $0.75 / $3.75 |
※単価は2026年9月時点のAPI登録価格です。各社の改定により変動する場合があります。
比較した2群・5つの業務処理
テスト対象は、実際の業務自動化で頻出する処理を模した以下の5項目です。
- A群:短い判定・生成タスク(短く・形式通りに・毎回正しく返せるかを検証)
- 意図分類:ユーザーの依頼内容(調べもの、メール下書き、画像生成など)を分類(40問×3回)
- 当否判定:生成された回答が利用者の問いに答えているかを3段階で判定(20問×3回)
- タイトル生成:会話内容から一覧用の短いタイトルを生成(10問×3回)
- 検索語生成:社内資料を検索するためのキーワード群を抽出(10問×3回)
- B群:文書の読み取りタスク(長い資料から数字や固有名詞を正確に拾えるかを検証)
- PDFの要点抽出:添付されたPDFの内容を400字以内で要約(5本×3回)
コストパフォーマンスの独自指標:「正答1件あたりの実費」
単に「APIの実行費用が安い」だけでは、間違った回答を頻発してやり直しが発生する場合、実質的なコストは跳ね上がります。そのため本検証では、以下の評価指標を定義しました。
正答1件あたりの実費 = 1回あたりの実費 ÷ 正答率
(※PDF要点抽出においては「すべての必須事実を過不足なく抽出できた1本あたりの費用」)
公平性を担保するための検証条件
- 全モデルに対し、全く同一のプロンプト(指示文)および入力データを使用
- 時間帯によるサーバー負荷の偏りを排除するため、同一の問いを4モデルへ同時にリクエスト送信
- 各モデルの「思考プロセス(推論)」機能は原則オフに設定(完全停止ができないGeminiは最小値の「低」に設定)
- B群のテスト用PDF(見積書、募集要項、請求書、議事録、月次実績表)はすべて検証用に作成された架空データを使用
3. 結果1:短い判定・生成ではGPT-6 Lunaが全問正解、費用は約1/23
正確さと形式遵守の比較
A群(計80問×3回試行=240回判定)における正答率は以下の通りとなりました。
| モデル | 意図分類 | 当否判定 | タイトル生成 | 検索語生成 |
|---|---|---|---|---|
| GPT-6 Luna | 100% | 100% | 100% | 100% |
| Claude Sonnet 5 | 100% | 100% | 100% | 100% |
| Claude Haiku 4.5 | 95.0% | 95.0% | 100% | 100% |
| Gemini 3.8 Flash(初期設定) | 98.3% | 10.0% | 90.0% | 100% |
GPT-6 Lunaは、4処理すべてにおいて100%の正答率を達成しました。一方、従来使われていたClaude Haiku 4.5には、SQL文の作成依頼を要約と誤認する、未回答の判定を見逃すといった軽微な分類ミスが確認されました。
正答1件あたりの実費比較(1ドル=150円換算)
短い判定・生成4処理を1回ずつ実行し、正答を得るためにかかった実費の合計比較です。
| モデル名 | 正答1件あたりの実費合計(4処理合計) | Haiku 4.5比 |
|---|---|---|
| GPT-6 Luna | 0.030 円 | 約 1/23 |
| Gemini 3.8 Flash(上限調整後) | 0.362 円 | 約 0.53 倍 |
| Claude Haiku 4.5 | 0.688 円 | 1.00 倍(基準) |
| Claude Sonnet 5 | 1.370 円 | 約 1.99 倍 |
(出典:信濃ロボティクスイノベーションズ合同会社 検証データ、2026年9月)
GPT-6 Lunaの4処理合計の実費はわずか0.030円であり、Claude Haiku 4.5(0.688円)と比較して約1/23という結果になりました。特に「意図分類」単体で比較した場合、実費比は約1/84に達しています。
Gemini 3.8 Flashの初期不調と原因
Gemini 3.8 Flashは、初期設定において当否判定の正答率が10%と極端に低い数値を記録しました。調査したところ、60回の試行のうち54回で「空文字」が返却されていました。
これはGeminiの内部的な思考プロセスが割り当てられた出力トークン上限(8トークン)を使い切ってしまい、最終的な回答を出力する前に制限に達したことが原因でした。出力上限を256トークンへ拡大して再検証したところ、当否判定を含め全処理で正答率100%を達成しました。モデルの能力不足ではなく、連携側のトークン設定に起因するものでした。
4. 結果2:PDFの読み取りではGemini 3.8 Flashが全問正解・最速
帳票読み取りにおける総合性能
B群(PDF 5本×3回試行)において、資料内の重要な数値、日付、取引先名などを正確に抽出できたかの結果です。
| モデル | 事実抽出率 | 完答率(全項目正解) | 誤読の有無 | 応答速度(中央値) | 完答1本あたりの実費 |
|---|---|---|---|---|---|
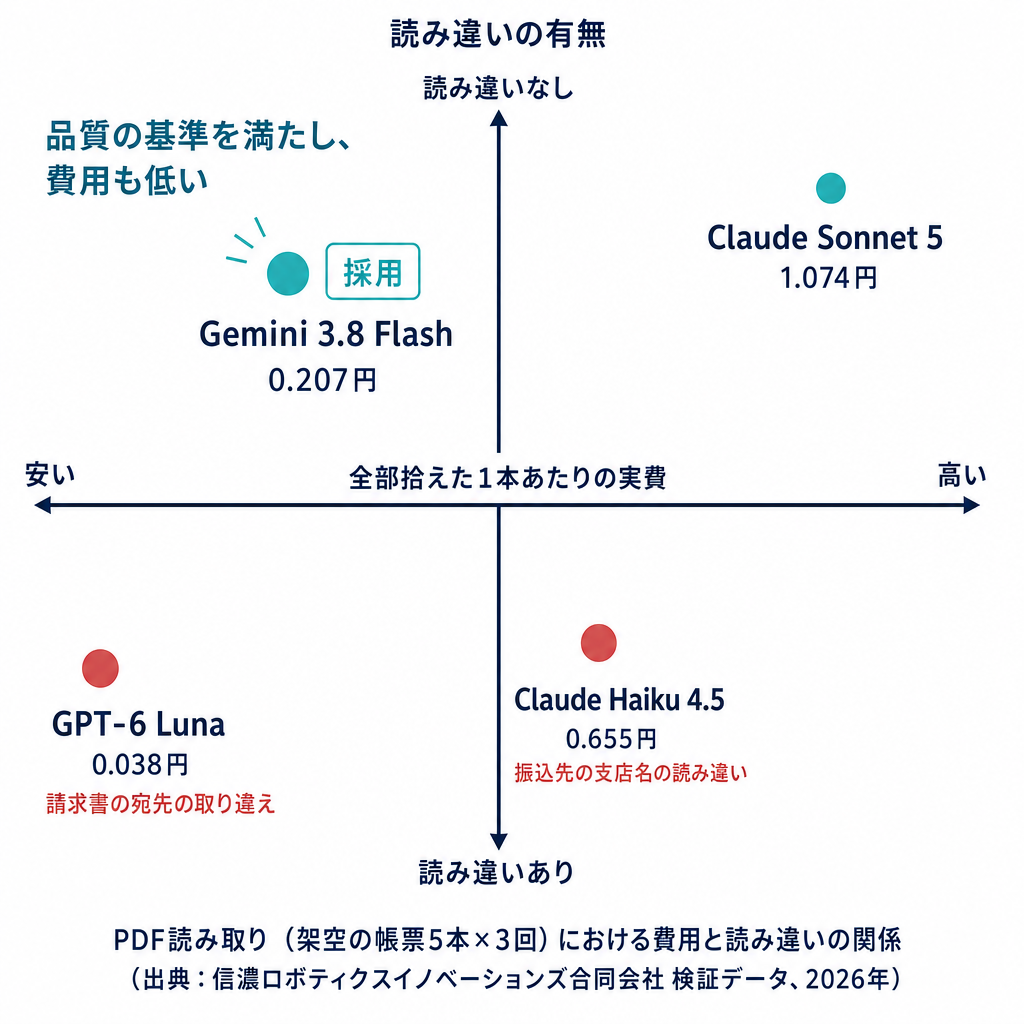
| Gemini 3.8 Flash | 100% | 15/15 | なし | 2.3秒 | 0.207円 |
| Claude Sonnet 5 | 100% | 15/15 | なし | 4.6秒 | 1.074円 |
| Claude Haiku 4.5 | 94% | 12/15 | あり | 3.8秒 | 0.655円 |
| GPT-6 Luna | 94% | 11/15 | あり | 2.6秒 | 0.038円 |
テキストデータが直接埋め込まれている通常のPDF(見積書、募集要項、議事録)については、4モデルとも100%の精度で正確に内容を抽出できました。差が生じたのは、「紙の書類をスキャンした画像化PDF(請求書、月次表)」の処理です。
誤読の実例とモデル選定の判断
スキャン形式の請求書において、モデルごとの挙動に明確な違いが現れました。
- Claude Haiku 4.5:振込先情報の読み取りにおいて、漢数字の「八」をカタカナの「ハ」と誤認し、支店名を取り違えるエラーが3回発生
- GPT-6 Luna:請求書の宛先会社名を別名称へ誤読するエラーが1回発生。振込先口座情報を要約から除外
- Gemini 3.8 Flash / Claude Sonnet 5:スキャン画像の文字認識も含め、誤読ゼロで完全に抽出
コスト面だけで見ればGPT-6 Lunaが完答1本あたり0.038円と圧倒的に安価ですが、請求書の宛先誤読や口座情報の欠落は、バックオフィス業務において致命的なトラブルに直結します。そのため、文書読み取り処理においては「誤読ゼロかつ最速で、Haikuの約4割のコストで運用できるGemini 3.8 Flash」が最適であると判断しました。
5. 中小企業が生成AIを選ぶための4つの教訓
本検証から得られた知見は、自社開発を行う企業だけでなく、日頃APIや各種AIツールを導入・運用している中小企業全般に当てはまります。
1. 得意な処理はモデルごとに明確に分かれている
短いプロンプトに対する分類や判定処理ではGPT-6 Lunaが抜群の費用対効果を発揮しましたが、画像を含む帳票OCRではGemini 3.8 Flashが圧倒的な安定感を示しました。「どのAIが一番賢いか」という単一の物差しではなく、「どの処理にどのAIを当てるか」という適材適所の視点が不可欠です。
2. 単価表の倍率と、実際のコスト差は一致しない
GPT-6 Lunaの公称単価はClaude Haiku 4.5の1/10ですが、実際の業務判定処理における実費は約1/84にまで圧縮されました。プロンプトの構造や入出力トークンの消費バランスによって実効コストは大きく変わるため、公称単価の比較だけで判断することはできません。
3. 最安モデルが正解とは限らない。「誤りの重さ」で判断する
コスト削減を最優先にして最安モデルを一律導入すると、OCRの読み違いのように業務上の損害を生むリスクがあります。エラーが許容される領域と、わずかな誤りも許されない領域を切り分け、品質基準を満たす中で最もコストパフォーマンスの高いモデルを選定する必要があります。
4. わずか数十問のテストでも適正は見極められる
今回の実証実験で使用したデータセットは、日常業務を想定した短い問い80問とPDF 5本です。これらを検証環境でテストするのにかかったAPI費用は、合計で約270円に過ぎませんでした。自社の業務データを数点用意してテストを実行するだけで、数万円単位のコスト削減や業務ミスの防止に繋がる示唆が得られます。
6. この評価の前提と範囲
本検証結果を客観的に解釈いただくため、以下の前提条件を明記します。
- 本検証は特定のプロンプト構造および入出力制限下で実施されたものであり、あらゆるタスクにおいて同様の精度順位を保証するものではありません。
- テストに使用したPDFは検証用に作成された架空の帳票であり、極端な汚れや強い傾きがある実物書類では異なる挙動を示す可能性があります。
- 1問ごとに独立してリクエストを送信しており、長大な文脈を保持する連続会話の性能を評価したものではありません。
7. 柔軟な切り替えを支えるマルチAI基盤「secondbrain.work」
今回の検証において、精度の確認から各処理のモデル切り替えまでをわずか1日足らずで完了できた背景には、グループ会社で運用している業務支援システム「secondbrain.work」のアーキテクチャがあります。
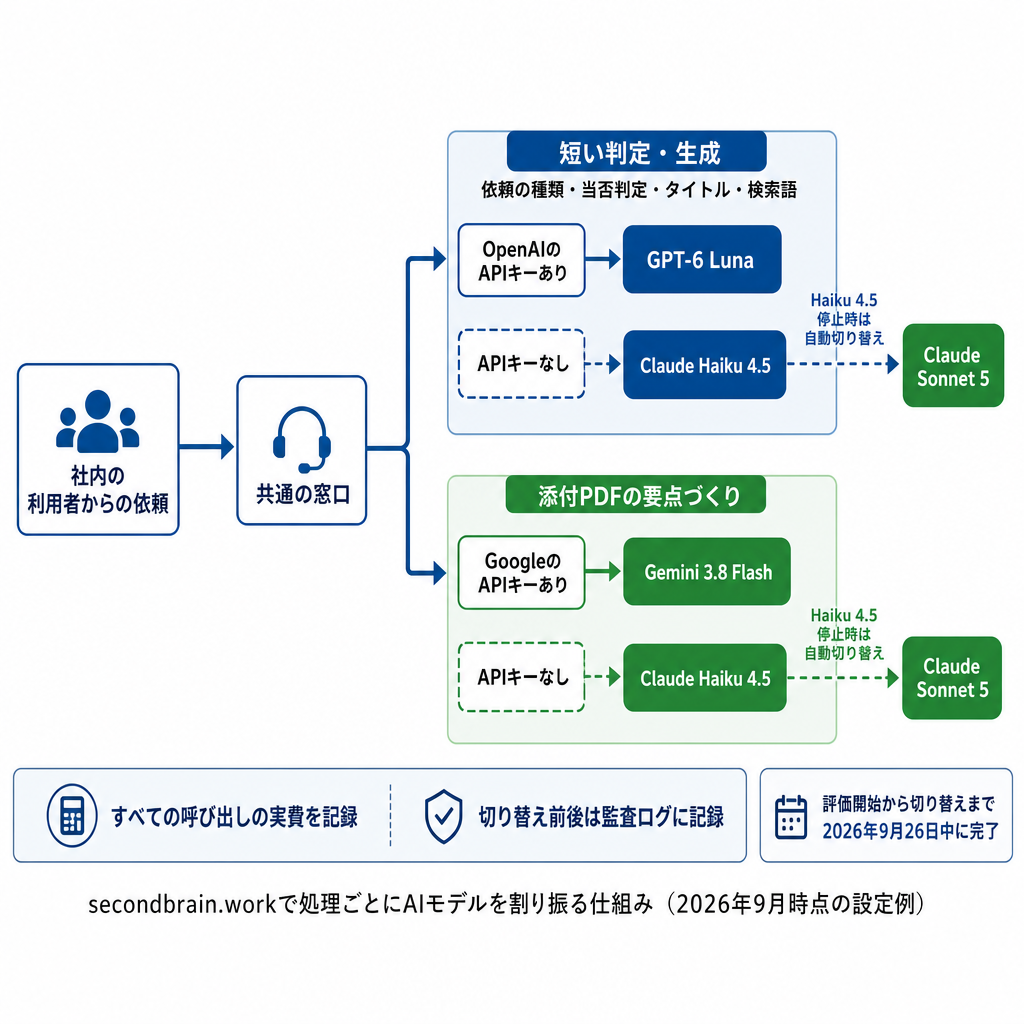
一般的なAIツールでは「ChatGPTかClaudeか」という単一ベンダーの選択になりがちですが、secondbrain.workは以下の役割分担を同一システム内でシームレスに実現します。
- 短い分類・判定・検索語生成:OpenAI GPT-6 Luna(高精度・超低コスト)
- 添付帳票・PDFの要点抽出:Google Gemini 3.8 Flash(高速・高精度OCR)
- 高度な推論・クリエイティブ作成:Anthropic Claude Sonnet 5(状況に応じた最適処理)
secondbrain.workの特徴
secondbrain.workは、信濃ロボティクスイノベーションズ合同会社が開発する、業務特化型のマルチAI基盤です。
- 複数社AIの自動最適ルーティング
OpenAI、Anthropic、Googleをはじめとする主要AIモデルを束ね、タスクの性質に応じて最適なAIへ自動で処理を割り振ります。ユーザーが毎回モデルの特性を意識することなく、常に最高水準の精度とコストパフォーマンスを両立します。 - 1社依存のリスクを排除
今回のように特定モデルの廃止や仕様変更が発表された際も、業務全体を止めることなく、裏側のモデル設定を柔軟に切り替えることが可能です。 - 社内コンテキストとのシームレスな統合
Google ドライブ、Gmail、Slack、社内ドキュメントなどの社内情報とセキュアに連携し、自社の業務文脈を踏まえた高精度な回答・下書き生成を実現します。
現在ChatGPTやClaudeの個別プランをご利用中の中小企業様にとっても、「単一ベンダーへの依存から脱却し、コストを最小化しながら業務適用を広げる」ための強力な選択肢となります。
【近日公開】ウェイティングリストの先行受付を開始いたします
secondbrain.workでは、企業の生成AI活用をより堅牢かつ経済的にアップデートする「マルチAI基盤」の一般提供に向け、近日中に公式ウェイティングリストの募集を開始いたします。
募集開始の正式なご案内や、自社の業務に合わせたAI基盤の選定・コスト最適化にご関心をお持ちの企業様は、ぜひ下記フォームよりお気軽にお問い合わせください。
※この記事は、信濃ロボティクスイノベーションズ合同会社の開発するマルチAIアシスタント「secondbrain」を利用して執筆しています。
ご興味をお持ち頂けた方は、ぜひ下記のフォームからお問い合わせください!